Caso de estudio: la app que falló sin un solo cambio en su código
Tus pruebas pasaron y nadie tocó tu código, pero tu app se cierra al abrirse. Analizamos cómo un cambio en las banderas de configuración del SDK de Google Analytics provocó fallas en iOS y qué lecciones nos deja para probar la integración con dependencias externas y vigilar producción.
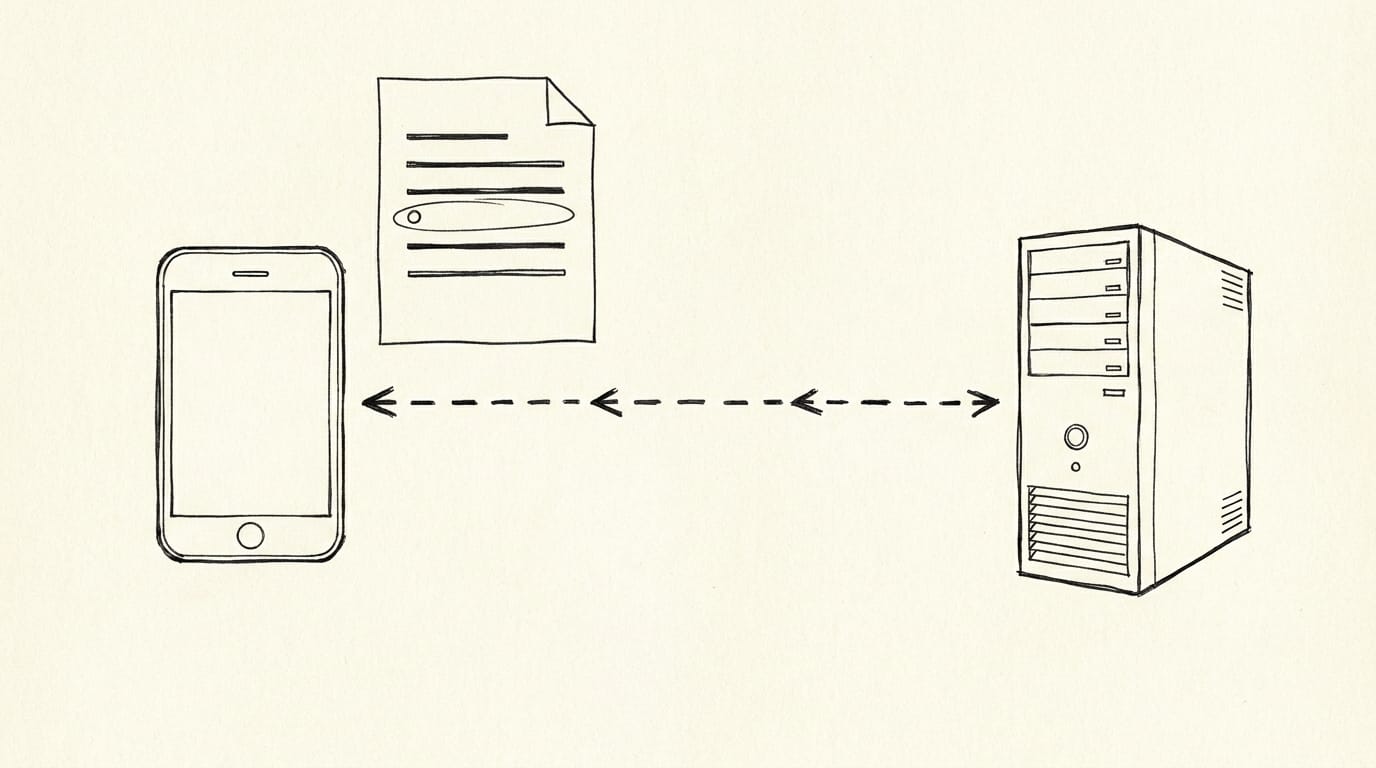
El 28 de septiembre de 2026, los usuarios de iOS experimentaron el cierre inesperado de diversas aplicaciones al momento de abrirlas. Tras un complejo proceso de depuración, los desarrolladores identificaron que el origen del problema se encontraba en el SDK de Google Analytics para Firebase.
El equipo de Google creía que todo funcionaba correctamente porque su panel de monitoreo de Firebase indicaba que el sistema operaba con normalidad. Se enteraron del problema únicamente después de recibir reportes de los desarrolladores en GitHub.
Este escenario se produjo por la combinación de tres errores en distintas capas del sistema:
- Defecto en la configuración: Una modificación en el archivo de banderas generó una estructura mal formada.
- Falta de validación de entradas: El código no comprobaba la integridad del archivo previo a procesarlo.
- Ausencia de manejo de excepciones: No se implementaron rutinas de gestión para controlar este tipo de excepciones.
Dado que los tres defectos residían en el código de Google, los desarrolladores no contaban con ningún recurso para corregir rápidamente estos cierres inesperados en sus aplicaciones.
Tras un incidente de esta magnitud, es natural preguntarse: ¿por qué nadie detectó las fallas a tiempo? ¿Acaso se realizaron pruebas? Y de ser así, ¿por qué las pruebas no detectaron los defectos?
En las siguientes secciones analizaremos a fondo la arquitectura del sistema afectado, las acciones preventivas que Google pudo haber implementado y las medidas que los desarrolladores pueden adoptar para mitigar los riesgos derivados del software de terceros. Al final encontrarás un método paso a paso para analizar cómo podría fallar tu propio software por aquello que está fuera de tu control.
Cómo funciona el sistema
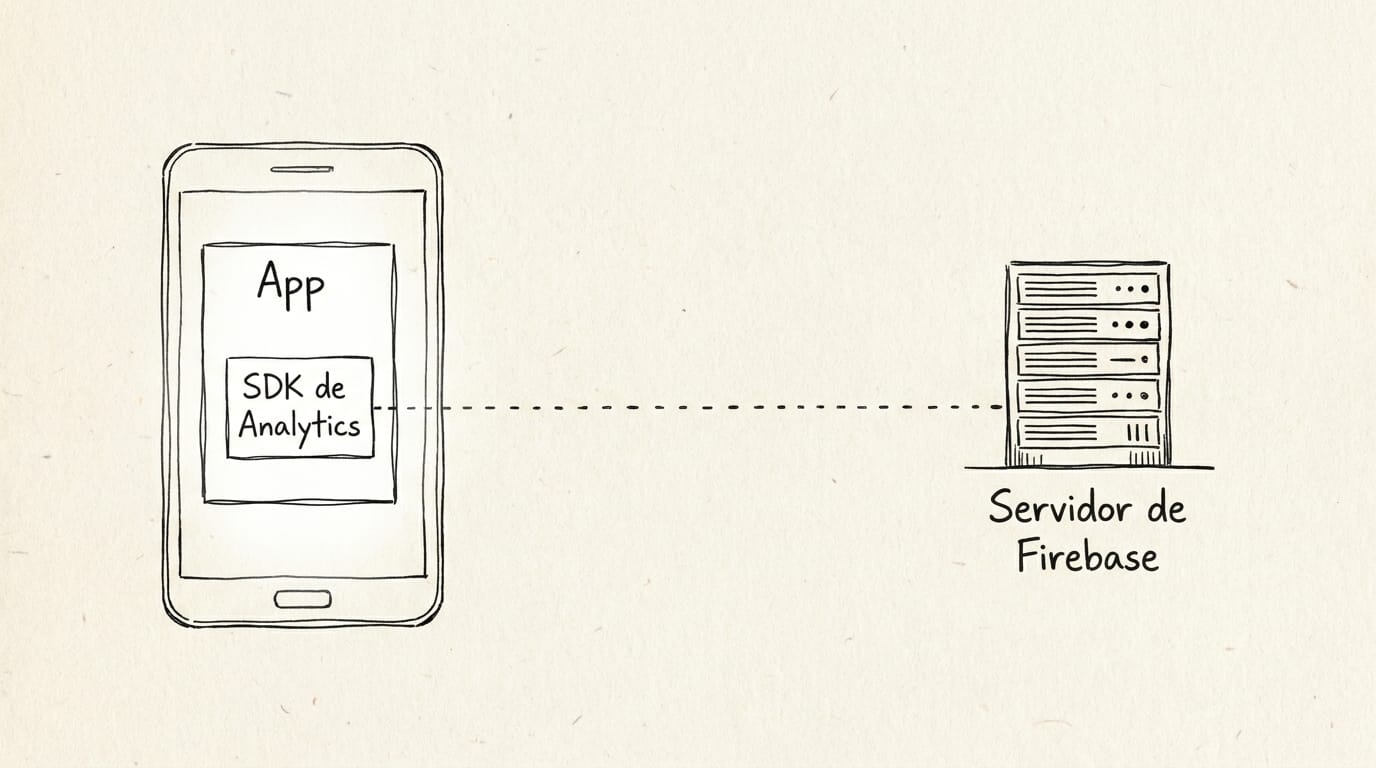
La integración del SDK de Google Analytics opera bajo una estructura bien definida:
Por un lado, en el dispositivo iOS reside la aplicación (el código desarrollado por el equipo de la app) junto con el SDK de Analytics. Este último consiste en un conjunto de bibliotecas provisto por Google que se compila dentro del mismo binario y se ejecuta en el propio proceso de la app con el fin de registrar la actividad de los usuarios.
Por otro lado, de forma externa en la nube, se encuentra el servidor de Firebase, con el cual el SDK mantiene comunicación periódica.
Definición y propósito de las banderas de configuración remota en el servidor
Cuando la aplicación se ejecuta, el SDK consulta al servidor de Firebase para determinar qué funciones internas deben activarse y con qué parámetros operar. Firebase denomina a estos ajustes «banderas de configuración remota» (flags), las cuales se organizan dentro del SDK en «experimentos». Cada bandera actúa como un interruptor definido por un nombre y un valor; un ejemplo de ello es diagnostics_enabled, que habilita o deshabilita las herramientas de diagnóstico.
El almacenamiento de estas banderas en el servidor permite a Google modificar el comportamiento del SDK globalmente en millones de aplicaciones sin requerir que los desarrolladores distribuyan una nueva actualización. De acuerdo con los informes de Firebase, su función primordial radica en actuar como un interruptor de emergencia (kill switch) para desactivar de forma remota y simultánea cualquier funcionalidad reciente que presente fallas no detectadas durante las fases de prueba.
Flujo de ejecución al iniciar la aplicación
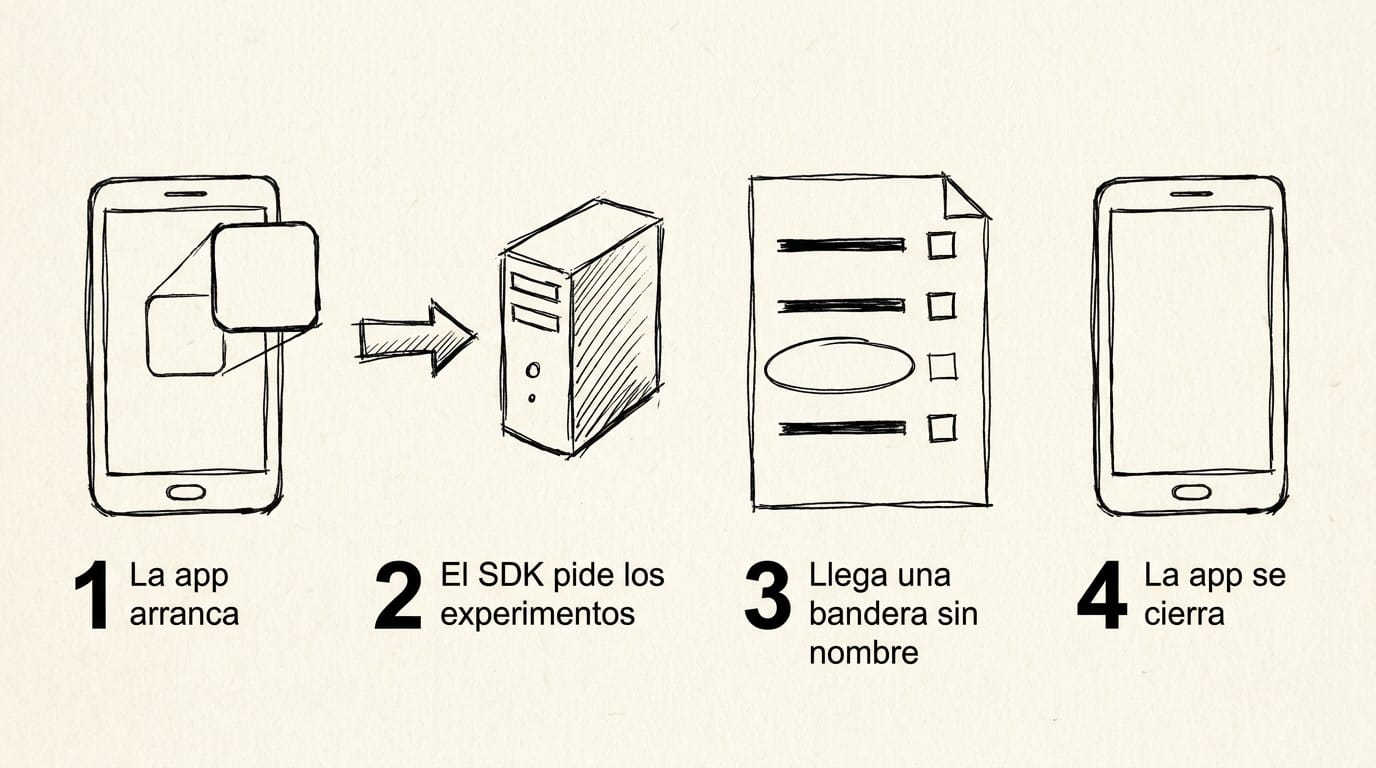
Según la reconstrucción del proceso realizada por los desarrolladores, la secuencia ocurre del siguiente modo:
- Inicia la aplicación y, simultáneamente, se inicializa el SDK.
- Transcurridos unos segundos, el SDK solicita las banderas de configuración al servidor de Firebase.
- El servidor envía la respuesta; la respuesta incluye las banderas compuestas por nombre y valor.
- El SDK almacena cada bandera en memoria utilizando su nombre como clave de acceso.
Google introduce el error en el archivo de configuración
Google cometió un error al editar el archivo de configuración para eliminar una bandera —un cambio sencillo de apenas dos líneas—, lo que derivó en la creación de una lista de banderas corrupta. Al emitir esta configuración defectuosa desde el servidor, se desencadenó un colapso generalizado: el SDK intentó procesar una entrada sin nombre, provocando una falla inmediata y el cierre inesperado de la aplicación.
El reto de la depuración
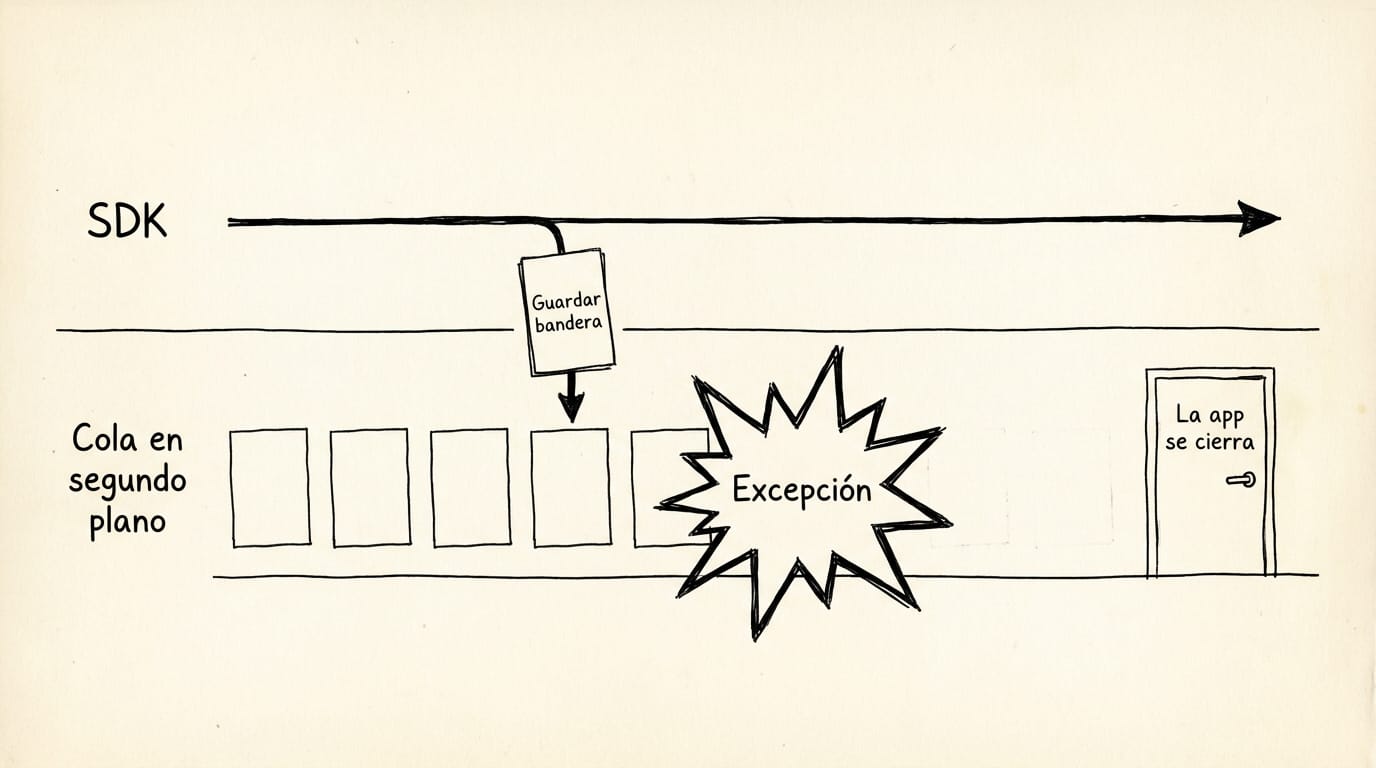
Comprender la causa raíz de este fallo resultó ser una tarea compleja. Ante una falla, un programa genera una excepción para notificar el problema. Si dispone de un manejo de excepciones adecuado, el sistema puede capturar la anomalía a tiempo y reaccionar de manera controlada (como descartar el dato defectuoso). No obstante, al carecer de una rutina de control para este caso particular, la excepción quedó sin gestionar, forzando al sistema operativo a cerrar la aplicación por completo.
El dilema principal residía en que una excepción solo se puede capturar si el fallo ocurre síncronamente, es decir, mientras el programa espera una respuesta. En este escenario, el SDK no procesa los parámetros de configuración de forma directa, sino que delega esa tarea a GoogleUtilities —una subdependencia del SDK—. Esta delegación busca garantizar que la aplicación continúe su secuencia de inicialización sin esperas, por lo que el procesamiento y guardado se efectuaban en segundo plano mediante una cola de trabajo.
Sin embargo, al ejecutarse en segundo plano, cualquier excepción emergente se volvía completamente invisible para la aplicación y los desarrolladores durante el diagnóstico. La corrección emitida posteriormente por Google confirma esta dinámica: la falla surgió dentro de la cola en segundo plano y no en el programa principal, lo que imposibilitaba interceptar el error previo al colapso del sistema.
Esta estructura asíncrona obstaculizó gravemente el diagnóstico. Los reportes de errores no asociaban la falla de manera directa con el código de la aplicación ni con el módulo de Analytics. Esta falta de precisión en los informes provocó que los equipos técnicos invirtieran un tiempo considerable en aislar la fuente del problema entre sus múltiples dependencias; un desarrollador, por ejemplo, tardó cerca de una hora en identificar cuál de las más de 30 dependencias integradas en su proyecto causaba el cierre repentino.
Por qué afectó a todos al mismo tiempo
El fallo ocurrió de forma inmediata y masiva debido a dos factores clave:
- Distribución global instantánea: Las banderas de configuración operan como interruptores de emergencia globales, difundiéndose al mismo tiempo a todas las aplicaciones conectadas.
- Vulnerabilidad transversal en el SDK: La ausencia de mecanismos de validación era intrínseca a la propia arquitectura del SDK en todas sus versiones distribuidas. Como precisó Google en su informe técnico, la respuesta mal formada «cerró apps en todas las versiones del SDK», de modo que ni actualizar la librería ni mantener versiones anteriores permitía eludir el problema.
Cómo pasó las pruebas
El informe de Firebase reconoce explícitamente la falla: «las pruebas existentes pasaron con el cambio que generó la configuración no válida». Aunque el informe no especifica cuáles eran esas pruebas, la discusión de la incidencia permite inferir sus deficiencias.
Apenas treinta y ocho minutos después del informe inicial, un grupo de desarrolladores logró reproducir el colapso utilizando una aplicación totalmente limpia que únicamente inicializaba Firebase: la aplicación falló en tres de tres instalaciones nuevas. Poco después, otro equipo replicó el problema en modo sin conexión al alimentar el SDK con estructuras de datos simuladas: cuando se incluía una clave válida, el flujo funcionaba normalmente; al suministrar una clave omitida o vacía, la aplicación colapsaba.
En consecuencia, las modificaciones se probaron únicamente en su lugar de origen (el servidor) y no en su entorno final de consumo (el SDK ejecutado dentro de una aplicación al procesar la nueva respuesta). Esta verificación en el punto de contacto es el objetivo central de una prueba de integración de sistemas: evaluar la interacción directa entre dos o más componentes. Una prueba automatizada que emulara la recepción del contenido remoto por parte de la aplicación habría detectado la falla de inmediato, tal como ocurrió en las pruebas independientes de los desarrolladores.
Las medidas de corrección anunciadas por Firebase atienden directamente estas deficiencias de cobertura:
- Validación cruzada con el cliente: Implementar comprobaciones automatizadas que restrinjan la publicación de cambios si la eliminación de un parámetro deja referencias no resueltas.
- Defensa en el SDK frente a datos remotos: El cliente validará la integridad de la respuesta e ignorará cualquier entrada corrupta sin interrumpir el proceso, bajo la premisa expuesta en el reporte de que las anomalías provenientes del servidor no deben provocar el cierre de las aplicaciones.
- Estrategias de despliegue progresivo: Distribuir las actualizaciones de configuración de manera gradual para contener el impacto de cualquier parámetro defectuoso en una fracción reducida de usuarios en lugar de afectar a toda la base instalada simultáneamente.
- Monitoreo orientado al cliente: Los paneles de monitoreo de Firebase permanecieron sin alteraciones durante el evento debido a que evaluaban el funcionamiento de la infraestructura del servidor y no las excepciones o cierres ocurridos en los dispositivos de los usuarios.
Alcance y limitaciones para los desarrolladores de las aplicaciones
Desde la perspectiva de los equipos de desarrollo, el fallo se originó en un factor externo. Como se expuso en nuestro post sobre la diferencia entre probar y depurar, existen incidencias derivadas de elementos ajenos al propio control donde no hay un defecto directo en el código de la aplicación. En este caso específico, el servicio externo no sufrió una caída, sino que envió información que el SDK no estaba preparado para procesar.
El margen de acción durante la crisis fue sumamente reducido. No era posible capturar el error ni prevenirlo mediante el cambio a otra versión del SDK. La publicación de una actualización de emergencia habría resultado inoportuna, pues cualquier versión para iOS requiere superar el proceso de revisión de la App Store antes de distribuirse a los usuarios, mientras que Firebase logró corregir la configuración remota en un lapso de 2 horas y 11 minutos. La capacidad de respuesta radicó en la detección temprana: las alertas iniciales provinieron de los sistemas internos de reporte de cierres a las 17:59 (dieciocho minutos después de la emisión de la lista corrupta), en tanto que las herramientas de estado de Firebase continuaban marcando un funcionamiento normal al monitorear exclusivamente sus servidores.
Lecciones e implicaciones para el desarrollo
- Identificar dependencias críticas para la estabilidad: Herramientas secundarias como la analítica pueden comprometer la ejecución al iniciarse junto con la aplicación. Todo SDK de terceros representa un riesgo de producto que afecta la calidad final, por lo que debe evaluarse según el impacto de un eventual fallo y no solo por las funciones que provee.
- Validar la resiliencia ante respuestas anómalas: Es recomendable evaluar el comportamiento del cliente frente a los servicios externos mediante el uso de proxies que simulen datos incompletos, lentos o corruptos. Detectar cierres bajo estas condiciones permite corregir vulnerabilidades antes de que afecten a los usuarios.
- Implementar monitoreo y observabilidad propios: La verificación de software continúa tras el despliegue mediante el seguimiento en entorno real (enfoque shift-right). Los paneles de estado de los proveedores confirman la operatividad de su infraestructura, pero no garantizan el correcto funcionamiento de la aplicación en el dispositivo.
- Disponer de mecanismos remotos de desactivación: Contar con un interruptor propio que consulte la conveniencia de inicializar un SDK externo permite mitigar riesgos sin requerir una nueva versión en la tienda. Aunque en este evento el cierre ocurrió en la primera ejecución, resulta indispensable ante fallos persistentes.
- Probar componentes desde la perspectiva del consumidor: Al actuar como proveedores de SDKs, APIs o configuraciones, las medidas correctivas adoptadas por Firebase sirven como marco de referencia para garantizar la estabilidad de los clientes.
Suscríbete sin costo a Diario Bug para desbloquear la descarga inmediata del kit de resiliencia: un método paso a paso, con hoja de trabajo, para analizar tus dependencias en equipo, y un skill para que tu agente de código aplique el mismo análisis a tu repositorio.
Conclusión
Los desarrolladores de estas apps habían pasado todas sus pruebas y no cambiaron nada, y aun así sus apps se cerraron. El defecto estaba dos niveles abajo en su cadena de dependencias, en una biblioteca que usaba el SDK, y lo detonó una lista que entregaban los servidores de Google. Las pruebas dicen cómo se comportó una versión en las condiciones que se probaron; no pueden ver un cambio hecho más abajo en la cadena. Lo que sí pueden hacer ambos lados es probar los puntos donde una pieza se comunica con otra: el proveedor, probando sus cambios desde el lado de sus clientes antes de que lleguen a todos; los desarrolladores, probando cómo reacciona su app cuando una dependencia se porta mal y vigilando la producción para enterarse antes de que alguien les avise.
Fuentes
- Mourits, Jerome; Kahn, Don, 2026. «Google Analytics for Firebase iOS SDK outage on September 28, 2026». The Firebase Blog, 2 de octubre de 2026. https://firebase.blog/posts/2026/10/firebase-analytics-outage
- firebase/firebase-ios-sdk, 2026. Issue #16728: «[Resolved] Crash in Analytics after sdk-exp response». GitHub, hilo del incidente con los reportes de los desarrolladores y las respuestas del equipo de Firebase. https://github.com/firebase/firebase-ios-sdk/issues/16728
- firebase/firebase-ios-sdk, 2026. Issue #16734: «[Analytics] APMEExperiment initWithExperimentID:flags: writes a nil flag name into GULMutableDictionary and crashes off-queue». GitHub, análisis técnico de un desarrollador externo. https://github.com/firebase/firebase-ios-sdk/issues/16734
- google/GoogleUtilities, 2026. Pull request #249: «Ignore nil keys in GULMutableDictionary instead of crashing», incluido en GoogleUtilities 8.1.4. https://github.com/google/GoogleUtilities/pull/249
- Glosario ISTQB: https://glossary.istqb.org/es_ES/home