Siete verdades incómodas sobre probar software
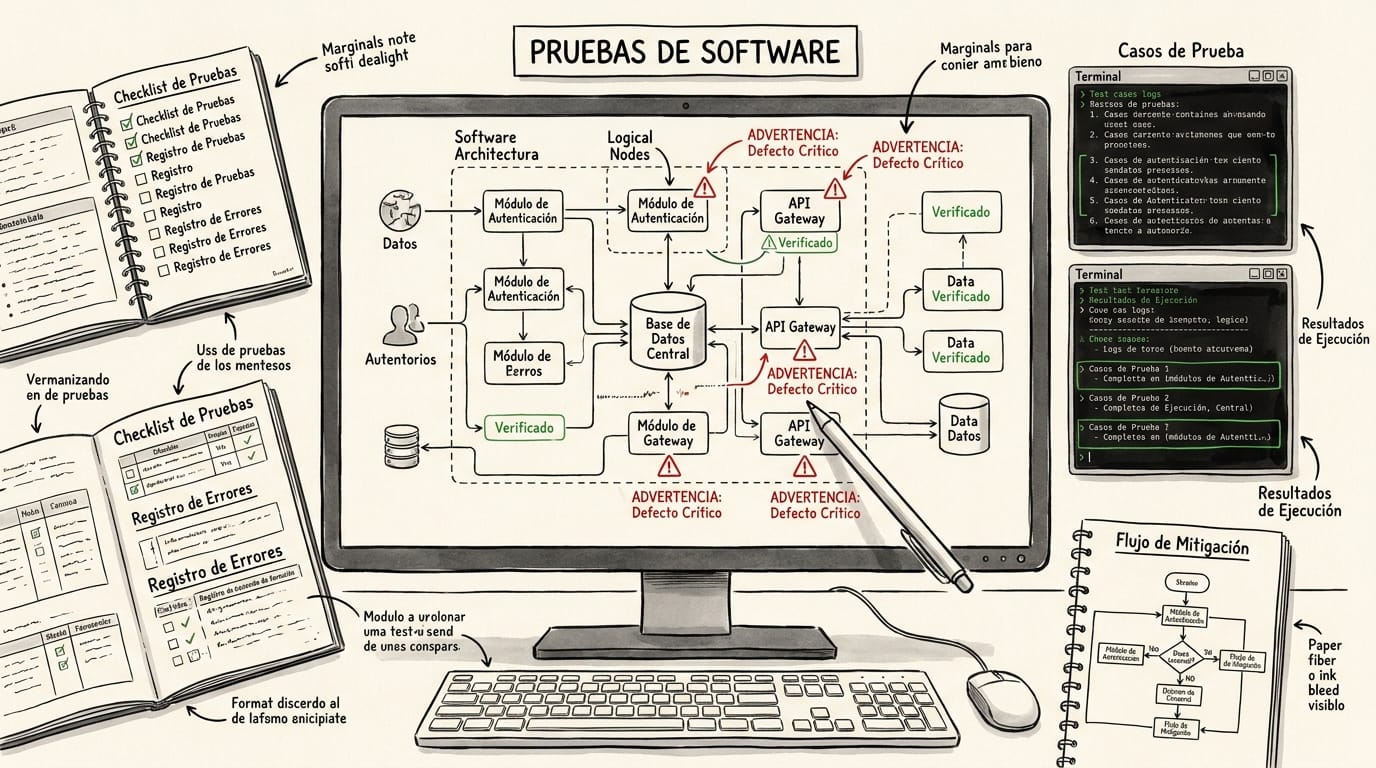
En los equipos de tecnología existe una expectativa común pero imposible: asumir que un ciclo de pruebas riguroso puede entregar un sistema totalmente libre de fallas. Cuando surge un incidente en producción, la primera reacción suele ser preguntar por qué el equipo de aseguramiento de calidad no detectó esa situación específica.
Esta expectativa ignora cómo funciona la ingeniería de software. Las pruebas no son un filtro mágico que garantiza la perfección matemática de un producto. Son una disciplina de exploración y mitigación de riesgos.
Para alinear las expectativas de negocio con la realidad técnica, la industria formalizó siete principios fundamentales de prueba. Estas reglas no son sugerencias de trabajo; son límites reales que determinan qué podemos y qué no podemos lograr al evaluar un sistema.
Conceptos clave antes de empezar
Para comprender estos principios, primero debemos separar con claridad cuatro conceptos que suelen confundirse en el trabajo diario:
- Error: Es una equivocación cometida por una persona al redactar un requisito, diseñar una pantalla o escribir una línea de código. Ya explicamos la distinción detallada entre error, defecto y fallo en entregas anteriores.
- Defecto: Es la imperfección concreta que queda registrada en el código o en un documento de trabajo a causa de un error humano. En la industria suele llamarse anomalía o inconsistencia.
- Fallo: Es la manifestación visible del defecto en tiempo de ejecución. Ocurre cuando el software no entrega el resultado que el usuario esperaba o interrumpe su operación.
- Caso de prueba: Es un conjunto de pasos estructurados con valores de entrada específicos, condiciones previas y resultados esperados para comprobar si una función cumple su objetivo.
La siguiente tabla resume los siete principios que rigen toda actividad de pruebas:
| # | Principio fundamental | Enfoque central | Lección operativa |
|---|---|---|---|
| 1 | Las pruebas demuestran la presencia de defectos | Falsabilidad empírica | Encontrar defectos reduce el riesgo, pero jamás demuestra ausencia total de fallas. |
| 2 | Las pruebas exhaustivas son imposibles | Combinatoria y recursos | Probar todas las combinaciones es inviable; debemos priorizar por riesgo. |
| 3 | Pruebas tempranas (Shift-Left) | Prevención económica | Revisar requisitos y código a tiempo evita retrabajos costosos más adelante. |
| 4 | Agrupamiento de defectos | Ley de Pareto (80/20) | La mayoría de las fallas se concentra en pocos módulos críticos del sistema. |
| 5 | Paradoja del pesticida | Mantenimiento de pruebas | Repetir las mismas pruebas deja de encontrar defectos nuevos; hay que actualizarlas. |
| 6 | Las pruebas dependen del contexto | Adaptabilidad operativa | Un sistema bancario requiere criterios de prueba distintos a los de una tienda móvil. |
| 7 | Falacia de la ausencia de errores | Utilidad contra especificación | Un sistema sin fallos técnicos evidentes fracasa si no resuelve el problema real del usuario. |
1. Las pruebas demuestran la presencia de defectos, no su ausencia
La ejecución de pruebas demuestra que existen defectos dentro de una aplicación. Sin embargo, ningún volumen de pruebas ejecutadas con éxito puede confirmar que el sistema carece por completo de anomalías.
Este principio fue expuesto por el científico de la computación Edsger W. Dijkstra en la Conferencia de Técnicas de Ingeniería de Software de la OTAN en Roma (1969) y en su texto Notes On Structured Programming (1970). Dijkstra argumentó que probar un programa confirma que no falló bajo los datos y condiciones específicas evaluadas, pero el resto de las combinaciones posibles queda sin verificar.
Por ejemplo, consideremos un formulario de registro de clientes en una aplicación web. Podemos ejecutar cincuenta casos de prueba con nombres convencionales, correos estándar y teléfonos locales. Todas las pruebas pueden salir exitosas. A pesar de ello, el sistema puede presentar un comportamiento erróneo cuando un usuario ingrese un apellido con apóstrofes o un teléfono internacional de longitud inusual.
El equipo de aseguramiento de calidad reduce la probabilidad de encontrar defectos en producción, pero no puede emitir un certificado de infalibilidad. Quien ejecuta la prueba evalúa el comportamiento, mientras que el desarrollador corrige el origen del problema; esta es la separación clara entre probar y depurar.
2. Las pruebas exhaustivas son imposibles
La prueba exhaustiva implica ejecutar todas las combinaciones posibles de datos de entrada, flujos de navegación y configuraciones del entorno. En la práctica, este enfoque es inviable por la explosión combinatoria del software.
Si un formulario de solicitud de crédito cuenta con diez campos independientes y cada campo acepta veinte valores distintos (entre válidos e inválidos), el total de combinaciones supera los 10 billones de variantes posibles. Evaluar cada posibilidad exigiría recursos y tiempos que ninguna organización posee.
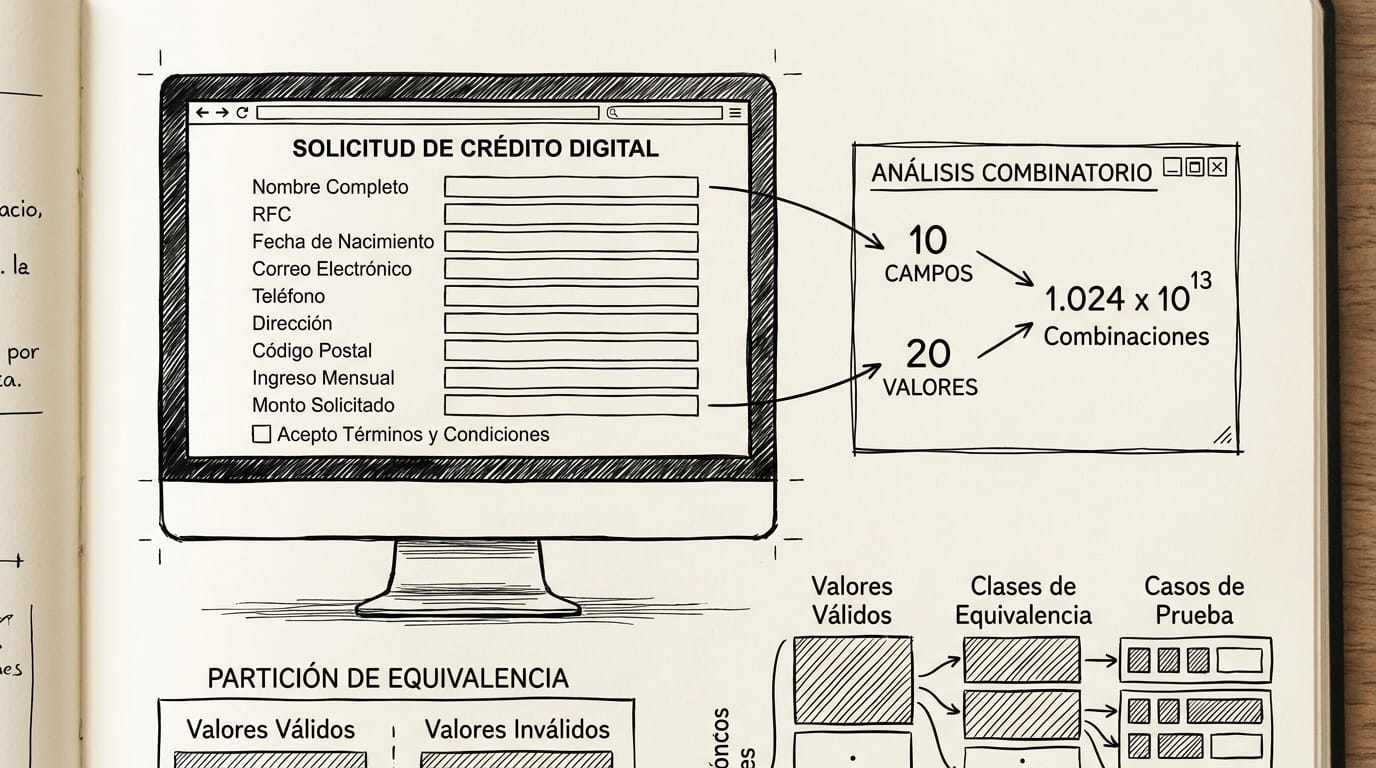
Para resolver esta limitación sin descuidar el sistema, aplicamos técnicas de diseño de pruebas como la partición de equivalencia, la cual agrupa valores con comportamiento similar para evaluar solo a un representante del grupo.
Caso histórico: El error en el procesador Intel Pentium FDIV (1994)
En 1994, Intel comercializó el procesador Pentium con un defecto en su tabla de consulta para divisiones en coma flotante. Faltaban cinco entradas en una matriz de 1,066 celdas dentro del chip. La probabilidad de activar el error con números aleatorios era de 1 en 9,000 millones, y la probabilidad de un error grave en el cuarto dígito rondaba 1 en 360,000 millones. Debido a esta baja frecuencia, los ciclos de prueba convencionales no detectaron la falla antes del lanzamiento. Ejecutar todas las operaciones numéricas posibles en un procesador habría tomado décadas de cómputo continuo. El incidente le costó a Intel 475 millones de dólares en reemplazos de procesadores y daños a su imagen pública.
Lo que enseña: La ejecución aleatoria masiva no sustituye a las técnicas rigurosas de análisis formal y reducción del espacio de búsqueda.
3. Pruebas tempranas (Shift-Left)
El principio de pruebas tempranas establece que las actividades de verificación deben comenzar desde el inicio del proyecto, mucho antes de contar con código ejecutable. Esta práctica se conoce como Shift-Left porque recorre las pruebas hacia la izquierda en el cronograma de trabajo.
Durante años se repitió que corregir un defecto en producción era exactamente cien veces más costoso que hacerlo en la etapa de diseño, citando una supuesta regla universal atribuida a IBM. Investigaciones recientes realizadas por Laurent Bossavit, Hillel Wayne y el análisis de Menzies y su equipo en 2016 sobre 171 proyectos demostraron que dicho estudio formal nunca existió y que esa proporción lineal no es una ley estricta.
A pesar de esa aclaración, la conveniencia económica de probar temprano sigue plenamente respaldada por la evidencia empírica. El investigador Barry Boehm observó que en sistemas grandes y críticos la resolución de problemas tras el despliegue sí puede ser hasta 100 veces mayor que en la etapa de requisitos, mientras que en sistemas pequeños o de bajo impacto la relación oscila alrededor de 5 a 1. Quien desee justificar estos presupuestos ante un comité directivo puede revisar el impacto económico de prevenir fallas frente a corregir tarde.
El estudio The Developer Coefficient, realizado por Stripe y Harris Poll, reveló que el desarrollador promedio destina más de 17 horas semanales a mantenimiento y depuración técnica, de las cuales 4 horas se consumen exclusivamente reparando código defectuoso. Esto representa cerca del 40% de la semana laboral de cada ingeniero.
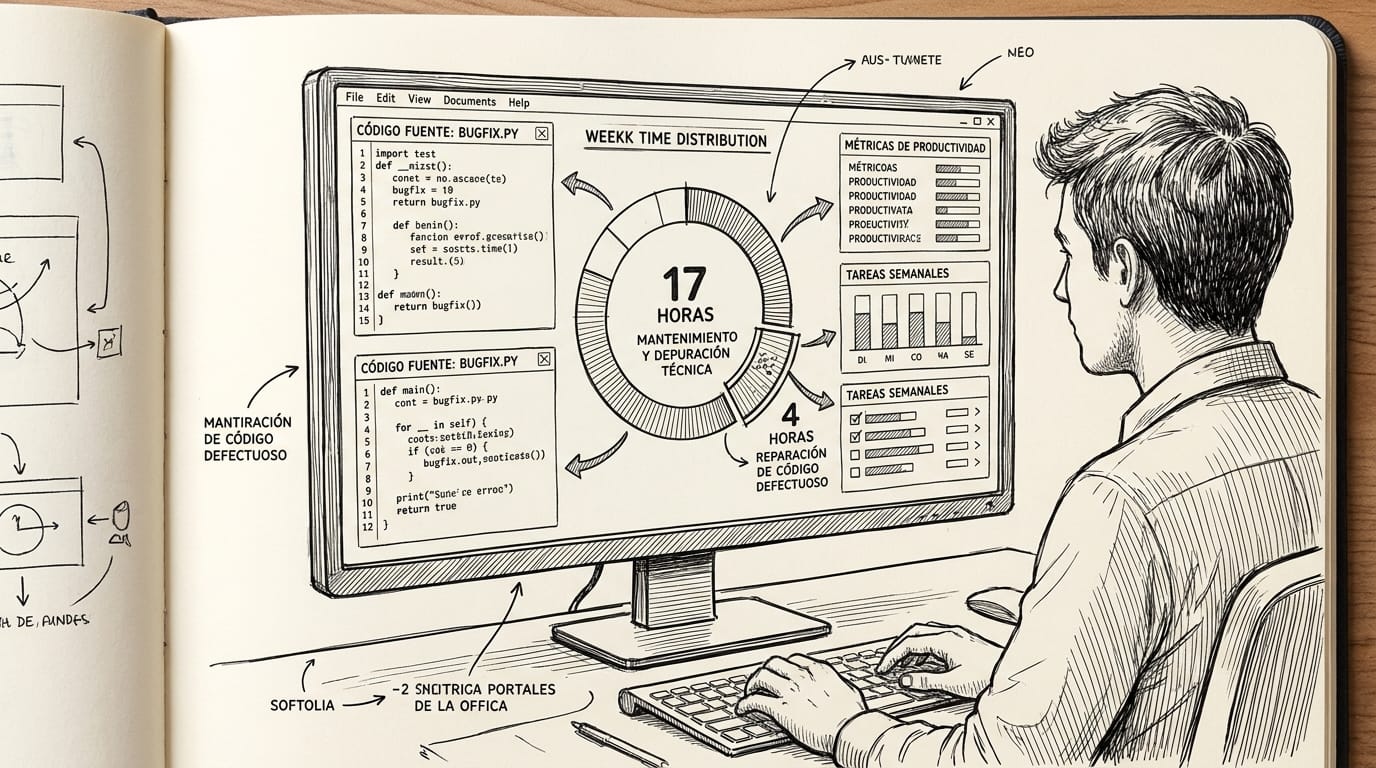
Aplicar análisis estático e inspección formal a las historias de usuario y diagramas de arquitectura ayuda a eliminar ambigüedades antes de que los programadores escriban código erróneo.
4. Agrupamiento de defectos
Los defectos no se reparten de forma regular en una aplicación. Por el contrario, la gran mayoría de las fallas operativas se concentra en un número reducido de módulos o componentes del sistema.
Este fenómeno sigue la Ley de Pareto, donde aproximadamente el 80% de los defectos reside en el 20% del código fuente. Investigaciones académicas como la de Fenton y Ohlsson (2000) documentaron esta concentración irregular. Su estudio reportó además que las métricas tradicionales de complejidad o tamaño de un módulo no siempre predicen dónde ocurrirán las fallas. En contraparte, Nagappan y Ball (2005) sí vincularon, en Windows Server 2003, la mayor densidad de defectos con los módulos sujetos a cambios constantes de código.
En un carrito de compras tradicional, por ejemplo, los módulos de catálogo y visualización suelen ser muy estables. La mayor parte de los incidentes se concentra casi siempre en el módulo de procesamiento de pagos y promociones, donde convergen inventarios concurrentes, cálculo de impuestos locales y pasarelas bancarias externas.
Caso histórico: La máquina de radioterapia Therac-25 (1985–1987)
Durante la década de 1980, el acelerador médico Therac-25 administró sobredosis masivas de radiación a varios pacientes en Estados Unidos y Canadá, provocando lesiones severas y muertes. Las investigaciones técnicas posteriores determinaron que la catástrofe no se originó en los módulos de interfaz de usuario ni en los sistemas de almacenamiento de expedientes. Prácticamente la totalidad de las fallas letales se agrupaba en una única rutina interna responsable de coordinar la sincronización entre los comandos del teclado y la posición de las placas mecánicas. El módulo carecía de protección frente a condiciones de carrera concurrentes.
Lo que enseña: Identificar los módulos críticos y concentrar el esfuerzo de análisis en ese 20% complejo del sistema salva vidas y recursos.
5. La paradoja del pesticida
El término fue propuesto por Boris Beizer en su libro Software Testing Techniques (1990). La analogía proviene de la agricultura: cuando se utiliza el mismo pesticida de manera continua sobre un cultivo, los insectos terminan por desarrollar resistencia y el veneno pierde su efectividad.
En el software ocurre lo mismo. Si un equipo ejecuta exactamente los mismos casos de prueba automatizados durante cada ciclo de entrega, esa batería de pruebas dejará de encontrar defectos nuevos. El código se vuelve "inmune" porque los defectos evidentes ya fueron subsanados, mientras que las fallas latentes residen en caminos que las pruebas actuales no recorren.
Para contrarrestar este fenómeno, debemos revisar, retirar y actualizar las pruebas de manera periódica. Variar los datos de entrada, cambiar los perfiles de usuario y diseñar casos de prueba alternativos permite desafiar la lógica del sistema bajo escenarios imprevistos.
Caso histórico: La caída de la red de larga distancia de AT&T (1990)
En enero de 1990, la red telefónica de larga distancia de AT&T sufrió un colapso continuo de 9 horas. El incidente impidió completar alrededor de 70 millones de llamadas (las estimaciones de la industria oscilan entre 50 y 75 millones) y dejó sin servicio a unas 60,000 personas. El fallo provino de una actualización de software en 114 conmutadores telefónicos modelo 4ESS. Las pruebas de regresión previas no detectaron el defecto porque evaluaban los mensajes de recuperación bajo condiciones controladas. El problema se activaba únicamente cuando un conmutador saturado enviaba dos señales consecutivas en un intervalo de microsegundos, desatando un error lógico en una sentenciaswitchen lenguaje C.
Lo que enseña: Las pruebas rutinarias que no varían sus tiempos ni sus patrones de concurrencia se vuelven ciegas a defectos complejos del sistema.
6. Las pruebas dependen del contexto
No existe una receta única para probar software. El enfoque, el nivel de rigor y las herramientas necesarias varían drásticamente según el propósito del producto, los riesgos operacionales y el marco normativo aplicable.
El estándar internacional de calidad ISO/IEC 25010 clasifica los atributos del software en características como seguridad, fiabilidad, rendimiento y usabilidad. Cada industria pondera estos atributos de forma distinta:
- Sistemas de misión crítica o médicos: Priorizan la tolerancia a fallas, la precisión numérica y el cumplimiento regulatorio estricto. Las entregas rápidas pasan a segundo plano.
- Comercio electrónico y aplicaciones móviles: Dan prioridad al tiempo de respuesta, la experiencia de usuario y la estabilidad bajo fluctuaciones de conexión a internet.
- Banca y servicios transaccionales: Concentran su atención en la integridad de los datos, el cifrado y la auditoría de operaciones financieras.
Un campo simple de fecha ilustra esta diferencia operativa. En una red social, un selector de fecha de nacimiento puede admitir formatos flexibles sin impacto grave si la pantalla tarda un segundo adicional en procesar la selección. En contraste, en un sistema de despacho de medicamentos de terapia intensiva, un campo de fecha y hora de administración debe calcular lapsos con precisión absoluta de segundos y validar husos horarios sin margen de ambigüedad. La estrategia de prueba debe moldearse en función del impacto real de cada producto.
7. La falacia de la ausencia de errores
Construir un sistema que supere todas las pruebas de código sin arrojar excepciones no garantiza que el proyecto sea un éxito comercial o funcional. Suponer que la falta de defectos técnicos equivale a un producto terminado constituye una trampa conceptual.
Este principio se fundamenta en la diferencia entre dos conceptos que rigen la ingeniería de sistemas:
- Verificación: Responde a la pregunta de si estamos construyendo el producto correctamente. Examina si el código satisface las especificaciones técnicas y los documentos de diseño redactados por el equipo.
- Validación: Responde a la pregunta de si estamos construyendo el producto correcto. Evalúa si la solución atiende las necesidades reales del usuario final en sus operaciones cotidianas.
Un equipo de trabajo puede alcanzar una alta cobertura en sus pruebas automáticas y entregar una aplicación sin fallas de ejecución. No obstante, si el software implementa un flujo confuso o resuelve un problema que el cliente no tiene, los usuarios rechazarán la herramienta. Incorporar la prueba de aceptación de usuario ayuda a confirmar que el comportamiento del producto aporte valor tangible al negocio.
Caso histórico: El satélite Nimbus-7 de la NASA y la capa de ozono (1978–1985)
Entre 1978 y 1985, el satélite Nimbus-7 de la NASA monitoreó el ozono atmosférico con el instrumento TOMS. El software encargado de procesar los datos satelitales funcionaba a la perfección técnica: no arrojaba excepciones y cumplía al pie de la letra con sus especificaciones. Los programadores habían configurado el algoritmo para marcar como sospechosa cualquier lectura por debajo de 180 unidades Dobson: era un umbral razonable, porque nunca se había registrado un valor confiable tan bajo. La lectura no se borraba, quedaba señalada para revisión manual. Como el sistema no reportaba errores informáticos, los especialistas asumieron que la capa de ozono se mantenía estable. Cuando científicos británicos detectaron el agujero en la Antártida mediante mediciones terrestres en 1985, la NASA revisó los datos históricos y descubrió que el satélite sí había detectado el fenómeno desde 1978, pero el filtro lo había marcado como dato anómalo en vez de como hallazgo real.
Lo que enseña: Un sistema técnicamente perfecto en su verificación falla si sus premisas básicas no concuerdan con la realidad operativa.
Conclusiones para el trabajo diario
Los siete principios de pruebas de software nos recuerdan que la calidad no se logra mediante promesas irreales de infalibilidad. Entender que las pruebas exhaustivas son imposibles y que los defectos tienden a concentrarse en zonas específicas permite enfocar los recursos de cómputo y tiempo en los puntos donde el impacto de negocio es mayor.
Al adoptar las pruebas tempranas y mantener una actualización constante de los casos de prueba, los equipos reducen el retrabajo técnico y previenen sorpresas operativas. La efectividad de un proceso de pruebas radica en administrar el riesgo con criterio profesional, demostrando fallas a tiempo y asegurando que el producto final aporte una solución práctica y confiable.
Fuentes
- Beizer, B. (1990). Software Testing Techniques (2nd ed.). Van Nostrand Reinhold.
- Boehm, B., & Basili, V. R. (2001). Software Defect Reduction Top 10 List. IEEE Computer, 34(1), 135-137. https://doi.org/10.1109/2.962984
- Burke, D. (1995). All Circuits are Busy Now: The 1990 AT&T Long Distance Network Collapse. California Polytechnic State University. http://users.csc.calpoly.edu/~jdalbey/SWE/Papers/att_collapse
- Dijkstra, E. W. (1970). Notes On Structured Programming (EWD249). Technische Hogeschool Eindhoven. https://www.cs.utexas.edu/~EWD/ewd02xx/EWD249.PDF
- Farman, J. C., Gardiner, B. G., & Shanklin, J. D. (1985). Large losses of total ozone in Antarctica reveal seasonal ClOx/NOx interaction. Nature, 315, 207-210. https://doi.org/10.1038/315207a0
- Fenton, N. E., & Ohlsson, N. (2000). Quantitative analysis of faults and failures in a complex software system. IEEE Transactions on Software Engineering, 26(8), 797-814. https://doi.org/10.1109/32.879815
- Halfhill, T. R. (1995, marzo). The Truth Behind the Pentium Bug. Byte. https://www.halfhill.com/byte/1995-3_truth.html
- International Software Testing Qualifications Board (ISTQB). (2023). Certified Tester Foundation Level (CTFL) Syllabus v4.0. https://www.istqb.org/certifications/certified-tester-foundation-level-ctfl-v4-0/
- International Software Testing Qualifications Board (ISTQB). Glosario ISTQB. https://glossary.istqb.org/es_ES/home
- ISO/IEC/IEEE 29119. Software and Systems Engineering - Software Testing.
- Leveson, N. G., & Turner, C. S. (1993). An Investigation of the Therac-25 Accidents. IEEE Computer, 26(7), 18-41. https://doi.org/10.1109/MC.1993.274940
- Menzies, T., Nichols, W., Shull, F., & Layman, L. (2016). Are Delayed Issues Harder to Resolve? Revisiting Cost-to-Fix of Defects throughout the Lifecycle. arXiv:1609.04886. https://arxiv.org/abs/1609.04886
- Nagappan, N., & Ball, T. (2005). Use of relative code churn measures to predict system defect density. En Proceedings of the 27th International Conference on Software Engineering (ICSE '05), 284-292. https://doi.org/10.1145/1062455.1062514
- Neumann, P. G. (Ed.). (1990). Cause of AT&T network failure. The RISKS Digest, 9(62). https://catless.ncl.ac.uk/Risks/9.62.html
- RealClimate. (2017). What did NASA know? and when did they know it? https://www.realclimate.org/index.php/archives/2017/12/what-did-nasa-know-and-when-did-they-know-it/
- Shirriff, K. (2024, diciembre). Intel's $475 million error: the silicon behind the Pentium division bug. Righto. https://www.righto.com/2024/12/this-die-photo-of-pentium-shows.html
- Stripe & Harris Poll. (2018). The Developer Coefficient: How software engineers are fueling the next global economic growth. https://stripe.com/files/reports/the-developer-coefficient.pdf