Pruebas de regresión: qué hacer cuando ya no se puede correr todo
Conforme el software crece, correr toda la suite en cada cambio resulta imposible por tiempo y costo. Para no frenar entregas ni perder confianza, se necesita una estrategia que defina qué pruebas correr, en qué punto de control y cómo priorizar por riesgo.
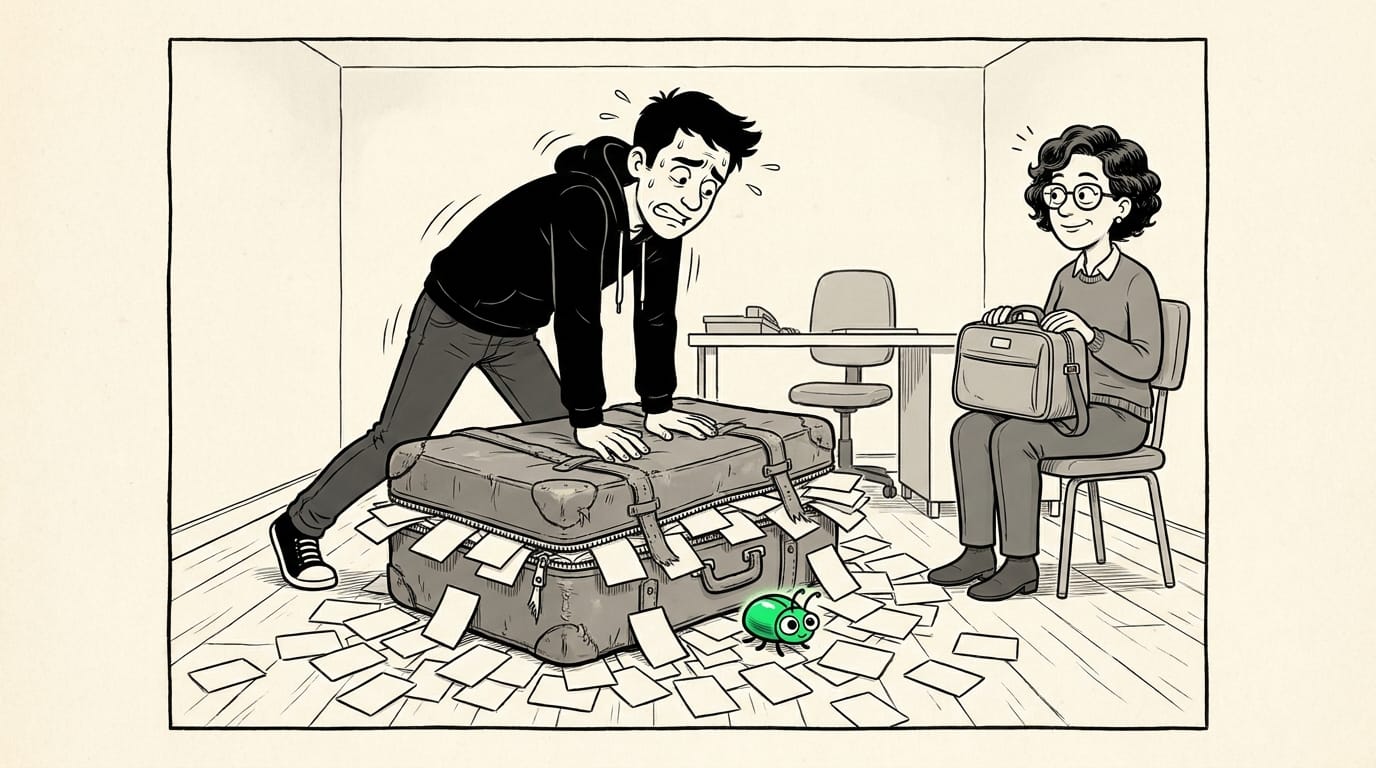
Cada vez que un sistema de software cambia, quedan dos preguntas: ¿el cambio hizo lo que debía? y ¿rompió sin querer algo que ya funcionaba? La primera la responden las pruebas del propio cambio: las de la nueva función o, si el cambio corrige un defecto, la prueba de confirmación; la segunda, las pruebas de regresión.
Como explicamos en el artículo sobre pruebas de confirmación y de regresión, un fallo puede aparecer lejos del código que se tocó.
La regresión no se limita a un nivel ni a un tipo de prueba. Revisa desde una pieza aislada del código hasta el sistema completo, y tanto lo que el sistema hace como la forma en que lo hace: su rendimiento, su accesibilidad, su seguridad, que revisa la prueba no funcional. Pensemos en una tienda en línea que modifica el cálculo de sus tarifas de envío. Su regresión incluye la función que calcula el envío, el carrito que la usa, una compra completa, el tiempo de respuesta de la página de pago y la accesibilidad de esa misma página.
En un mundo ideal, cada cambio correría todas las pruebas del sistema: de todos los niveles y tipos, automatizadas y manuales. En la práctica, eso deja de ser posible conforme el sistema crece.
En este artículo explicamos qué abarca la regresión y por qué, con el tiempo, ya no se puede correr completa en cada cambio. Después vemos las tácticas y los pasos que siguen equipos de distintos tamaños para armar su estrategia: qué pruebas correr, dónde, cuándo y cómo, y cómo mantener sana su suite de pruebas.
El crecimiento natural de la suite de pruebas
Cada función nueva y cada defecto corregido suman pruebas, y casi todas pasan a formar parte de la regresión, para asegurar que esas funciones sigan operando en el futuro. Así, la suite crece sola.
Como la regresión se corre con cada cambio, la automatización de pruebas es la forma principal de hacerla en un tiempo razonable.
Pero cuando la suite crece sin una estrategia, se vuelve inmanejable, y aparecen problemas en cuatro frentes:
- El tiempo de ejecución. La ejecución completa tarda cada vez más e impacta la velocidad de entrega.
- La estabilidad de las pruebas. Surge la inestabilidad en las pruebas, fallando o pasando al azar sin cambios en el código. Esto provoca que el equipo pierda confianza y termine omitiendo alertas sobre fallos auténticos.
- La relevancia de las pruebas. Se acumulan pruebas de funciones que ya no existen, o que nadie recuerda por qué se escribieron. Corren, cuestan tiempo y no protegen nada.
- El costo de mantenimiento de la suite. Resulta costoso mantener el conjunto de pruebas actualizado, relevante y libre de inestabilidades.
Por eso hace falta una estrategia clara. Una estrategia decide qué pruebas correr, dónde, cuándo y cómo, con tres metas: una regresión eficiente, una suite estable y resultados confiables.
Las tácticas y decisiones fundamentales
Las tácticas que siguen se combinan; ningún equipo usa sólo una. Las tres primeras crecen con el proyecto: un equipo pequeño aplica su versión sencilla y una empresa con una suite enorme, la más sofisticada. La cuarta, cuidar la salud de la suite, no es una etapa: es trabajo de todos los días, a cualquier escala. En cada una importa el principio, no la herramienta que lo aplica.
1. Separar lo pequeño y rápido de lo grande y lento
Google clasifica sus pruebas por tamaño:
- Pequeñas: corren en un solo proceso, sin red ni disco.
- Medianas: corren en una sola máquina.
- Grandes: pueden ocupar varias máquinas. Google las reserva casi siempre para probar el sistema completo, de extremo a extremo (E2E).
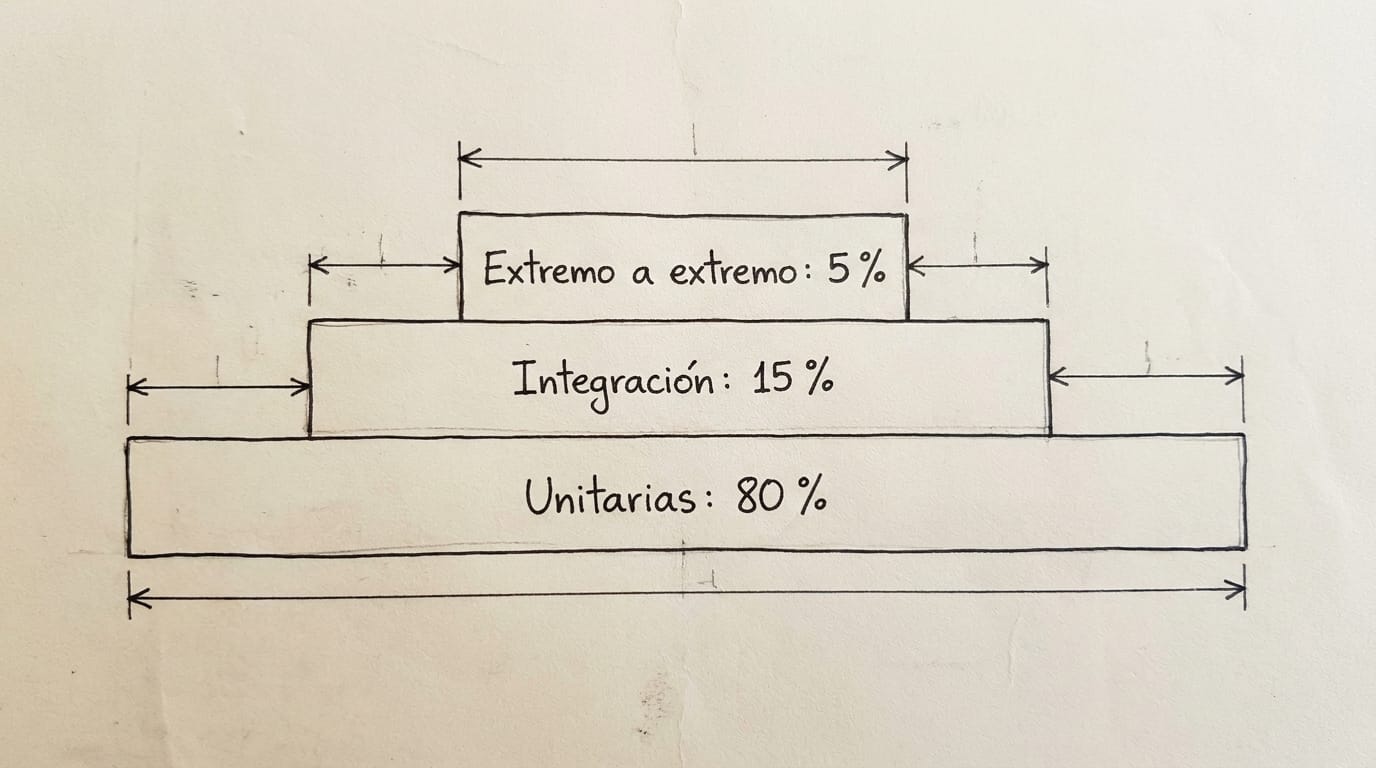
El tamaño no es lo mismo que el alcance, es decir, cuánto del sistema revisa una prueba. Por alcance, Google apunta a que cerca del 80% sean pruebas unitarias, el 15% de integración y el 5% de extremo a extremo.
El principio es simple: lo pequeño y rápido corre en cada cambio; lo grande y lento, después. La mayoría de los equipos de Google corren sus pruebas pequeñas antes de aceptar cada cambio, porque son las más rápidas y confiables. Muchos apartan las grandes y las corren sólo al construir y liberar una versión.
2. Elegir en qué punto de control corre cada prueba
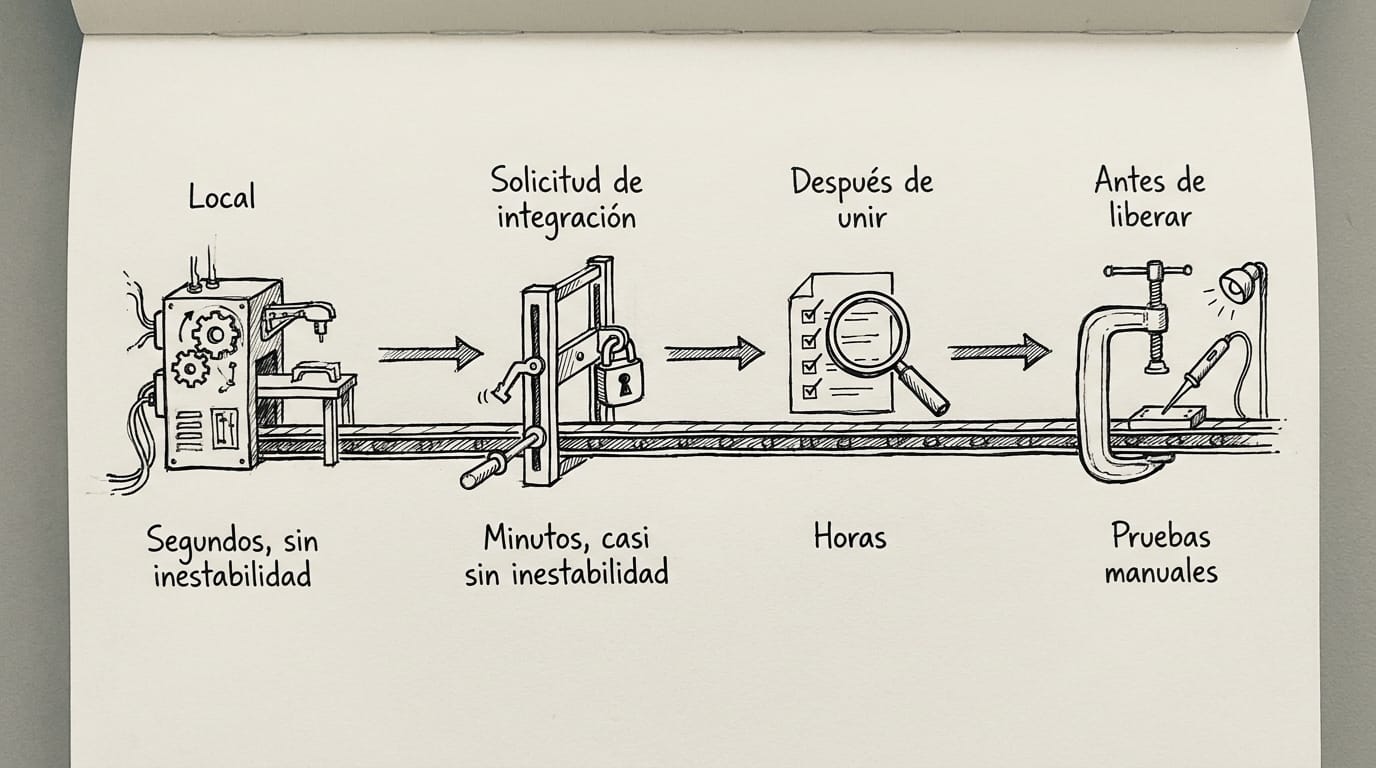
Además de elegir qué pruebas correr, hay que decidir dónde corre cada una. A lo largo del desarrollo hay varios puntos de control (gates). Cada punto de control tolera cosas distintas: cuánto pueden tardar sus pruebas, cuánta inestabilidad acepta y a quién le avisa el resultado:
- Durante el desarrollo local: Tolera segundos y nada de inestabilidad, porque quien espera es la misma persona que escribe el código. Aquí sólo caben las pruebas rápidas de lo que se modificó.
- En cada solicitud de integración (Pull Request): Bloquea la unión (merge) del código. Tolera minutos y casi nada de inestabilidad. Aquí corren las pruebas de humo, una lista fija con los flujos más críticos del producto, y las pruebas de lo que el cambio puede afectar.
- Después de unir el cambio (merge), o de forma programada (Nightly): No bloquea a nadie, así que tolera un par de horas y pruebas que usan una base de datos real. El resultado le llega a todo el equipo.
- Antes de liberar, con pruebas manuales: Aquí va lo que necesita a una persona o un ambiente completo. Es el punto más caro de repetir y se reserva para lo crítico.
3. Priorizar por riesgo y selección inteligente
No todas las partes del sistema importan igual, ni todas se rompen con la misma facilidad:
- Priorizar por riesgo: Una práctica común es una matriz de probabilidad contra impacto de un fallo. Para los fallos con mayor probabilidad y alto impacto se corren todas las pruebas relacionadas. Para lo improbable y de poco impacto no se prueba y se asume el riesgo.
- Elegir según el cambio: Para evitar correr todo, se traduce la lista de archivos modificados en pruebas mediante áreas del código (reglas estáticas), dependencias (herramientas que mapean qué partes del código están conectadas) o, a gran escala, historial predictivo (modelos de aprendizaje automático entrenados con metadatos de integración continua (CI) como los que usaba Meta).
4. Cuidar la salud de la suite
Elegir bien qué correr sirve de poco si lo que corre no es confiable. Martin Fowler recomienda poner en cuarentena cada prueba inestable (flaky), fuera de la ejecución principal. La otra mitad del trabajo es podar: borrar las pruebas de funciones que ya no existen o reescribir las que se rompen con cada cambio interno.
Cómo diseñar una estrategia de regresión paso a paso
Para un equipo que quiere poner orden en su suite de pruebas sin frenar las entregas, diseñar una estrategia es un proceso práctico de cuatro pasos:
Paso 1: Medir y clasificar el inventario actual
No se puede optimizar lo que no se mide. Antes de cambiar nada, conviene responder:
- ¿Cuánto tarda hoy en ejecutarse la suite completa?
- ¿Qué porcentaje de esas pruebas son unitarias, de integración o de extremo a extremo (E2E)? Cada una corresponde a uno de los niveles de prueba.
- Meta: Como regla práctica, si las pruebas E2E pasan del 15% del total, es una señal de alarma. Conviene planear cómo mover algunas verificaciones hacia pruebas unitarias o de integración aisladas.
Paso 2: Definir los puntos de control y sus límites
Se asigna cada prueba al entorno cuya tolerancia cumpla:
- Local: Segundos, cero inestabilidad (unitarias de lo tocado).
- Pull Request: Minutos, pruebas de humo y módulos afectados.
- Nightly / Programado: Horas, pruebas pesadas o con bases de datos reales.
- Pre-liberación: Validación humana y flujos críticos finales.
Paso 3: Elegir el mecanismo de filtrado (empezar simple)
- Nivel Inicial: Etiquetas (tags) o áreas de código (
si cambia envíos, corre #envios). - Nivel Intermedio: Herramientas de construcción que conocen las dependencias del código y corren sólo las pruebas de lo que depende de lo que cambió.
- Nivel Avanzado: Si el repositorio es gigantesco, conviene evaluar herramientas de análisis de impacto, que eligen las pruebas según el código que recorre cada una, o de selección predictiva, que las eligen a partir del historial de resultados.
Paso 4: Establecer reglas estrictas de salud
- Toda prueba inestable (flaky) va a cuarentena automática para no bloquear despliegues.
- Por experiencia, conviene ponerle un límite (por ejemplo, 14 días): si nadie la arregla, la prueba se elimina. Una prueba que miente es peor que ninguna.
- En la práctica, las pruebas de mutación o las revisiones periódicas permiten borrar con confianza código de prueba obsoleto.
La estrategia en la práctica: Dos escenarios
La estructura básica de una estrategia aplica para todos, pero su implementación varía radicalmente según la escala.
Escenario A: Un proyecto de software pequeño o mediano
En un equipo ágil tradicional (como nuestra tienda en línea), la estrategia busca velocidad y simplicidad:
- Estructura: División simple entre pruebas unitarias (rápidas) y E2E/integración (lentas).
- Ejecución: En cada Pull Request, el servidor de CI ejecuta todas las pruebas unitarias (menos de 5 minutos) y una prueba de humo del login y el carrito.
- Selección: Si el cambio es muy específico, seleccionan las pruebas E2E mediante etiquetas (tags).
- Mantenimiento: Las pruebas inestables se desactivan manualmente y se crea un ticket para arreglarlas. De noche, se corre la suite completa.
Escenario B: Operando a la escala de Google o Meta
Cuando el repositorio es masivo y miles de desarrolladores integran código a la vez:
- Estructura: Una proporción de referencia por alcance (cerca de 80/15/5) y tiempos máximos por defecto para las pruebas grandes.
- Ejecución: Los cuatro puntos de control están instrumentados. En los Pull Requests corren sobre todo pruebas rápidas y confiables; correr ahí las E2E depende de cada equipo.
- Selección: Grafos de dependencias internos (en Google, el sistema TAP) o modelos predictivos entrenados con historial (Predictive Test Selection), que a la escala de Meta seguían detectando más del 95% de los fallos de prueba.
- Mantenimiento: Herramientas que detectan las pruebas inestables y las sacan temporalmente de la ejecución principal mientras alguien las corrige.
Conclusión
La regresión comprueba que un cambio no alteró, sin querer, nada fuera de sí mismo. Abarca lo que el sistema hace y cómo lo hace, en todos los niveles y tipos de prueba. Lo ideal sería correr todo en cada cambio, pero el tiempo, el costo y el crecimiento natural de la suite lo impiden.
Construir una estrategia de regresión significa tomar el control de esa red de seguridad. Ya sea un equipo pequeño apoyándose en reglas simples y ejecuciones nocturnas, o una corporación global utilizando modelos predictivos y cuarentenas automatizadas, el objetivo es el mismo: separar lo pequeño de lo grande, colocar las validaciones correctas en los momentos adecuados, priorizar el riesgo real y mantener una suite sana, en la que el equipo confíe porque cada fallo que reporta significa algo.
Fuentes
- Bender, A. (2020). "Testing Overview". En T. Winters, T. Manshreck y H. Wright (eds.), Software Engineering at Google, capítulo 11. O'Reilly. https://abseil.io/resources/swe-book/html/ch11.html
- Fowler, M. (2024). Continuous Integration. martinfowler.com. https://martinfowler.com/articles/continuousIntegration.html
- Fowler, M. (2011). Eradicating Non-Determinism in Tests. martinfowler.com. https://martinfowler.com/articles/nonDeterminism.html
- Machalica, M., Samylkin, A., Porth, M., y Chandra, S. (2018). Predictive Test Selection. arXiv:1810.05286. https://arxiv.org/abs/1810.05286
- Microsoft. (2026). Use Test Impact Analysis - Azure Pipelines. Microsoft Learn. https://learn.microsoft.com/en-us/azure/devops/pipelines/test/test-impact-analysis
- Tannenbaum, R. (2020). "Continuous Integration". En T. Winters, T. Manshreck y H. Wright (eds.), Software Engineering at Google, capítulo 23. O'Reilly. https://abseil.io/resources/swe-book/html/ch23.html
- Glosario ISTQB. International Software Testing Qualifications Board. https://glossary.istqb.org/es_ES/home